Архітектура
Архітектура даних: від таблиці до розподіленої системи
У главі 15 ми зберегли причини архітектурних рішень. Тепер зосередимося на даних, навколо яких ці рішення виникають: як описати факт, як не допустити…
У главі 15 ми зберегли причини архітектурних рішень. Тепер зосередимося на даних, навколо яких ці рішення виникають: як описати факт, як не допустити суперечливих змін, що означає «система знає», звідки беруться копії та що робити, коли процес або мережа зупиняються посеред операції.
Це велика тема, тому главу поділено на послідовні підглави. Ми почнемо з рядків і зв’язків, перейдемо до пошуку, транзакцій і конкурентних змін, а тоді розглянемо репліки, розподілення, часткові відмови, потоки подій та еволюцію схеми. Назви баз тут допомагають побачити різні форми й гарантії; вони не утворюють рейтинг продуктів.
Після глави читач уміє:
- описати сутність даних, типи, ключі, зв’язки, обмеження та запити;
- вибрати між реляційною, документною, ключ-значення та графовою моделлю за формою даних і питанням користувача;
- розпізнати, де індекс допомагає пошуку, а де додає ціну запису;
- пояснити транзакцію, цілісність та конкурентну зміну конкретним прикладом;
- відрізнити синхронну та асинхронну реплікацію, репліку від резервної копії, джерело від похідного набору;
- назвати наслідки затримки, мережевого розділення, повтору і неоднозначної відповіді;
- добирати пакетну та потокову обробку, кеші, представлення й міграції без твердження про універсальне exactly-once.
Усі числові значення в навчальних сценаріях позначають вигадані дані. Приклади не є вимірами реального продукту. Посилання на конкретну версію PostgreSQL чи Kafka означає гарантію саме наведеного продукту й документації, а не кожної бази даних.
16.1. Дані, схема і запит
Дані — це записані факти, які продукт має пам’ятати або обчислювати. Схема визначає форму цих фактів: які є таблиці чи документи, поля, допустимі типи, ключі та правила цілісності. Запит просить систему знайти, додати, змінити або поєднати дані для певної потреби.
У реляційній базі таблиця має рядки й стовпці. Рядок описує один екземпляр сутності; стовпець — одну властивість у визначеному домені. Запис бронювання може містити ідентифікатор, ідентифікатор клієнта, часовий слот, статус та час створення. Число місць має бути цілим значенням; ціна потребує точного десяткового типу або подання у найменших одиницях валюти, а не двійкового числа з округленням. Тип звужує випадкові помилки, але не замінює бізнес-правило: ціна 0 може бути допустимою, а ціна −12 — ні.
Під час першої появи розшифруймо SQL (Structured Query Language — структурована мова запитів). Умовний фрагмент нижче створює навчальне сховище для клієнтів та бронювань:
CREATE TABLE customers (
    customer_id bigint PRIMARY KEY,
    email text NOT NULL UNIQUE
);

CREATE TABLE bookings (
    booking_id bigint PRIMARY KEY,
    customer_id bigint NOT NULL REFERENCES customers(customer_id),
    starts_at timestamptz NOT NULL,
    status text NOT NULL CHECK (status IN ('held', 'confirmed', 'cancelled'))
);
Це синтаксис PostgreSQL, а не універсальна команда для всіх двигунів. Первинний ключ і зовнішній ключ тут не декоративні назви: перший ідентифікує рядок; другий обмежує значення customer_id наявним клієнтом. NOT NULL вимагає значення в колонці, а UNIQUE забороняє повторити адресу електронної пошти в цій таблиці. Реальні правила про повторне використання адреси чи збереження особистих даних треба визначити окремо.
NULL у реляційній моделі означає, що колонка не має звичайного значення. Це не обов’язково нуль, порожній текст або слово «невідомо» — причина відсутності може бути різною, і сам SQL-тип її не пояснює. Перевірка на NULL пишеться окремо; порівняння column = NULL не працює як звичайне порівняння рівності. Якщо «ще не надіслано», «користувач відмовився» і «даних не отримали» ведуть до різної поведінки, краще зберегти різні стани, а не зливати їх у пусте поле.
Модель даних починається з потреби читати й змінювати факт, а не з конкретної таблиці. Наприклад, сторінка підтвердження має показати, кому, коли і на який слот зроблено бронювання; зміна бронювання має зберегти нову версію статусу й не зайняти недоступне місце. Із цих потреб стає зрозуміло, які значення мають бути канонічними, які зв’язки треба зберегти та які запити є основними.
Завершений приклад. Навчальний продукт приймає бронювання 45-хвилинних консультацій. Для демонстрації є двоє клієнтів, три слоти і кожен слот має одне вільне місце; ці числа вигадані. Оператор має бачити бронювання за тижнем і клієнтом. Схема відділяє клієнта від бронювання, не зберігає ім’я клієнта повторно у кожному бронюванні та задає статус із відомого переліку. Коли ім’я змінюється, команда оновлює один запис клієнта; коли клієнт скасовує бронювання, система може залишити рядок із новим статусом, не стираючи факт, що бронювання колись існувало. Це не вирішує автоматично строки зберігання чи правові вимоги: вони потребують окремого правила продукту й доступу.
Схема теж змінюється. Додавання нового статусу впливає на обмеження, старі клієнти, звіти та код оброблення. Тому у вимозі бажано назвати допустимі переходи, а не покладатися на те, що будь-який рядок тексту буде безпечним. У главі 52 процедура міграції розглядається окремо; тут важливо побачити, що схема є контрактом даних, з яким мають узгодитися читачі й писачі.
Джерела до підглави 16.1: матеріали звірено 23 вересня 2026 року. PostgreSQL 18: основи визначення таблиць і стовпців, обмеження і первинні/зовнішні ключі. Ці сторінки описують поведінку PostgreSQL 18; навчальне бронювання вигадане.
16.2. Ідентичність, ключі і кардинальність
Ключ відповідає на питання «як упізнати саме цей запис?». Природний ключ — наявне значення предметної області, наприклад номер квитка, яке має бути унікальним за правилом. Штучний ключ — ідентифікатор, створений системою, наприклад booking_id. Природний ключ зручний, коли справді стабільний; електронна адреса не завжди підходить, бо люди її змінюють і адреса може мати приватний характер. Штучний ключ стабілізує посилання, але не робить предметну сутність унікальною сам по собі. Якщо двічі зареєструвати той самий партнерський номер, випадкові ідентифікатори не зупинять дублікат — потрібне окреме обмеження унікальності на доменне значення.
Кардинальність зв’язку описує, скільки записів можуть бути пов’язані:
- Один клієнт може мати багато бронювань; одне бронювання посилається на одного клієнта.
- Одне бронювання групи може містити кілька послуг, а одна послуга траплятися у багатьох бронюваннях. Це зв’язок «багато-до-багатьох», який у реляційній моделі зазвичай зображують проміжною таблицею.
- Два записи не обов’язково повинні посилатися одне на одного лише тому, що їх часто показують на одній сторінці. Спільний екран — це вимога читання, а не доказ спільної ідентичності.
Для послуг бронювання можна зберегти ціну на момент покупки в проміжному рядку:
CREATE TABLE booking_services (
    booking_id bigint NOT NULL REFERENCES bookings(booking_id),
    service_id bigint NOT NULL REFERENCES services(service_id),
    price_at_booking numeric(12, 2) NOT NULL CHECK (price_at_booking >= 0),
    PRIMARY KEY (booking_id, service_id)
);
Комбінація двох зовнішніх ключів виражає відношення, а складений первинний ключ не дозволяє додати ту саму послугу до того самого бронювання двічі. Поле price_at_booking є знімком вартості на момент підтвердження; поточна ціна послуги в іншій таблиці може пізніше змінитися. Це свідома історична копія, а не випадкове дублювання. Якщо продукт дозволяє одну й ту саму послугу кілька разів в одному бронюванні, ключ має включати позицію або окремий рядковий ідентифікатор — правило визначає бізнес-модель.
Зовнішній ключ захищає зв’язок від значень, що вказують на неіснуючий батьківський запис. Він не визначає автоматично, що робити при видаленні клієнта: блокувати видалення, знеособити клієнта, каскадно видалити історію чи зберегти бронювання без особистих даних. Виберіть дію відповідно до вимог аудиту, конфіденційності й відновлення. Не ставте каскадне видалення лише тому, що воно є в синтаксисі бази.
Завершений приклад. Клієнт Марта має бронювання B-17, B-23 і B-31. У кожному рядку бронювання зберігається посилання на один customer_id, тож ім’я та контакт не треба копіювати в усі три рядки. У бронюванні B-23 Марта обрала консультацію й переклад; два зв’язки перебувають у booking_services, кожен зі своєю зафіксованою ціною. Коли ціна консультації зміниться наступного місяця, старий рахунок відображатиме ціну, зафіксовану у бронюванні, а каталог — нову. Якщо товарну позицію можна повторити, команда додає quantity або окремий номер позиції, а не послаблює правила наосліп.
Джерела до підглави 16.2: матеріали звірено 23 вересня 2026 року. PostgreSQL 18: зовнішні ключі та посилальна цілісність, первинні ключі й унікальні індекси, обмеження унікальності. Приклад таблиці зв’язків є навчальним; семантику видалення має встановити власник продукту.
16.3. Реляційна, документна, ключ-значення і графова моделі
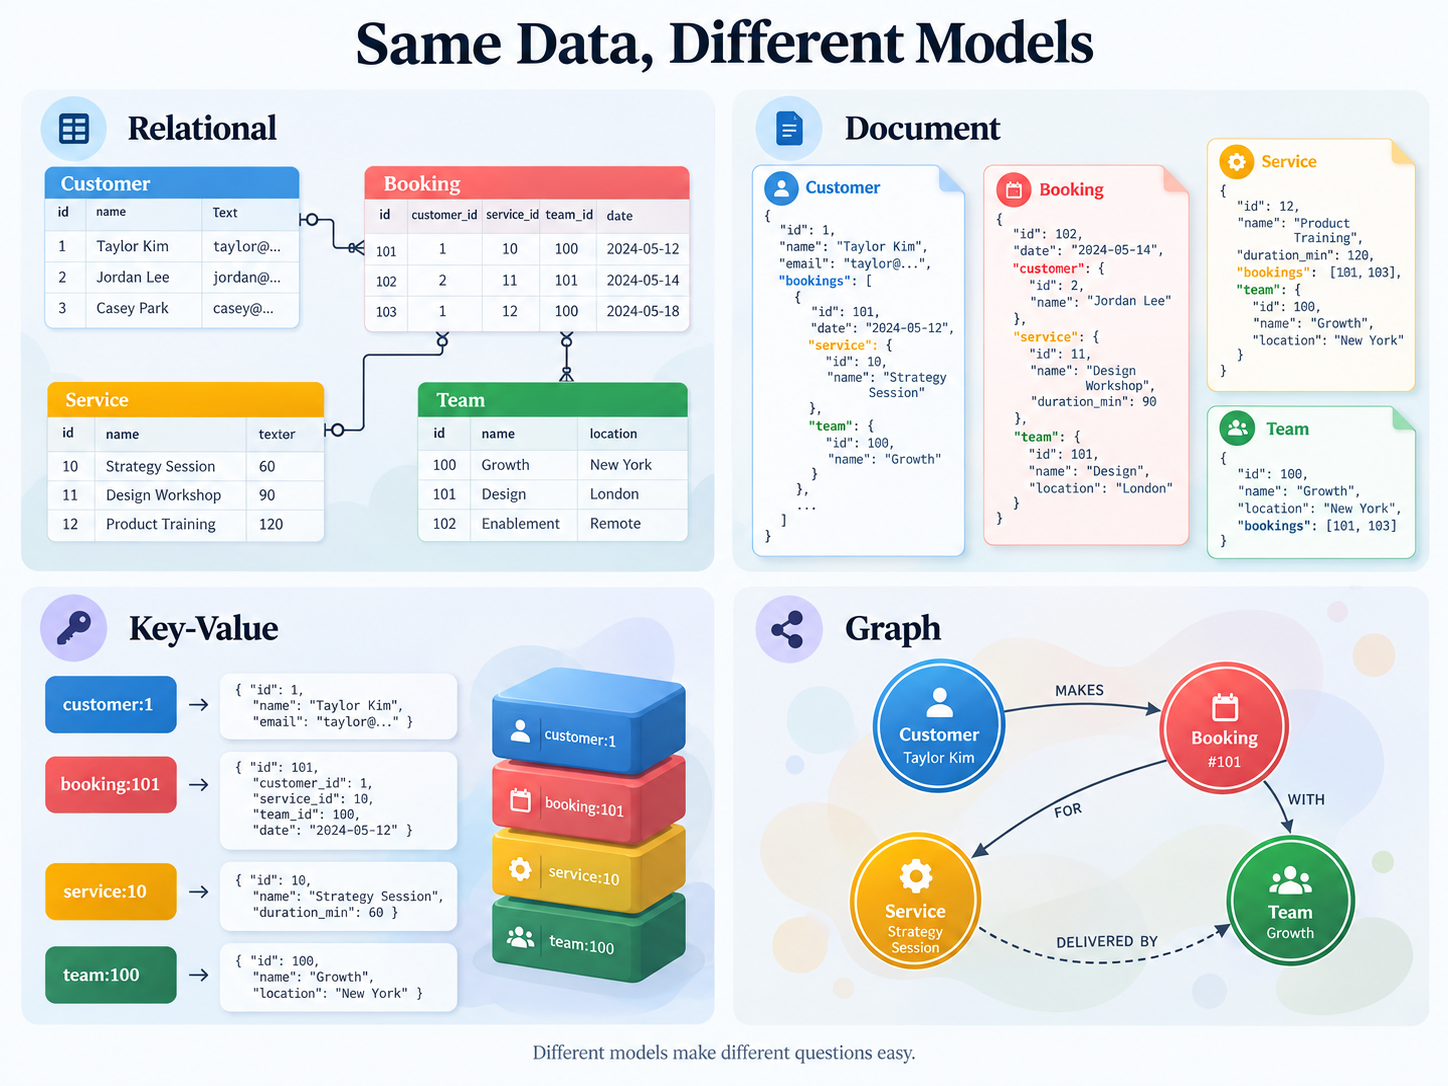
Різні моделі полегшують різні операції. Реляційна модель корисна, коли важливі явні зв’язки, обмеження і запити, які поєднують кілька сутностей. Документна модель групує пов’язані поля в документ, що може бути зручним для читання цілого агрегату; складні зв’язки між багатьма документами можуть вимагати додаткового пошуку або підтримання копій. Ключ-значення добре відповідає прямому доступу за відомим ключем; воно не означає, що система вміє ефективно знаходити запис за будь-яким його полем. Графова модель робить вершини й зв’язки виразними, коли продукт ставить багато питань про шляхи та сусідство — наприклад, як професійні контакти пов’язані за кілька переходів.
Це не поділ на «старі» та «сучасні» бази. Одна технологія може підтримувати кілька способів представлення, а одна система може мати кілька сховищ із різним призначенням. Вибір починається з форми основних операцій та відповідальності за дані. Запитайте: хто змінює цей факт; які поля мусять лишатися разом; чи потрібні транзакції між ними; за якими умовами читають; як знайти чи перебудувати похідне подання; що команда спроможна спостерігати і відновлювати?
Нормалізація розміщує окремі факти в структурі, яка зменшує непотрібні копії та суперечливі оновлення. Якщо адресу клієнта повторювати в кожному бронюванні, після зміни адреси частина історії може містити старе значення, а частина — нове. Посилання на один запис клієнта усуває таку неоднозначність для поточного профілю.
Денормалізація навмисно копіює або попередньо обчислює інформацію, щоб конкретне читання стало простішим або швидшим. Наприклад, щоденний підсумок може зберігати загальну кількість підтверджених бронювань. Тоді читач має запитати, коли й ким він оновлюється, як знайти розбіжність із канонічними бронюваннями та чи можна повністю його перерахувати. Копія не є безкоштовною оптимізацією: вона створює правило узгодження та іноді короткий проміжок застарілості.
Завершений приклад вибору. Команда бронювання розглядає дві операції: підтвердити бронювання з кількома послугами й щодня показати звіт про завантаженість. Для запису замовлення потрібні посилальні обмеження й одна атомарна зміна стану, тому команда зберігає канонічні клієнтів, слоти, бронювання та позиції у реляційних таблицях. Пошук активних бронювань за клієнтом і датою є типовим запитом. Аналітичний звіт може початися із запиту до тих самих таблиць; якщо вимірювання покажуть, що звіт конкурує з підтвердженнями за ресурси, його можна перенести до окремого похідного подання чи аналітичного сховища. Документна форма тут не відкинута як неправильна, але саме вона не знімає вимогу атомарно перевірити останнє місце. Ключ-значення не відповідає на запит звіту без додаткових індексів або структури. Графове сховище не обирають, бо ключовим запитом поки не є пошук складних шляхів між людьми, послугами й організаціями.
Перш ніж додати таку копію, визначте, хто її оновлює, наскільки застарілою вона може бути та як звірити або перебудувати її з канонічних даних.
Можна денормалізувати дані лише після визначення власника похідного значення, процедури перебудови та допустимої затримки. Інакше команда отримує два потенційні джерела правди й не знає, яке показувати під час розбіжності. Для подальшого читання до підглави 16.3: Designing Data-Intensive Applications, 2nd edition — зміст. Можливості й гарантії конкретного продукту перевіряйте в його документації.
16.4. Операційні записи й аналітичні читання
OLTP (Online Transaction Processing — оброблення операційних транзакцій) описує робочі зміни окремих фактів: створити бронювання, змінити контакт, скасувати замовлення. OLAP (Online Analytical Processing — аналітичне оброблення даних) описує запити, які підсумовують багато фактів: порівняти завантаженість за місяцями, знайти тенденцію відмов або оцінити дохід за послугами. Межа проходить за типом роботи, а не за назвою продукту чи двигуна: та сама реляційна база може обслуговувати обидва види запитів, поки навантаження та час відповіді це дозволяють.
Канонічні дані — факти, яким продукт надає офіційне значення: підтверджене бронювання, його власник, слот і ціна на момент угоди. Похідні дані обчислюють із канонічних: денний підсумок, пошуковий індекс або кеш. Копія може прискорити читання, але стає додатковою відповідальністю. Для кожного похідного подання заздалегідь назвіть джерело, власника оновлення, припустимий вік, сигнал застарілості, процедуру повної перебудови й те, що покаже система, коли подання недоступне.
Завершений приклад звіту. Умовна служба бронювання має 18 місяців історії. Її менеджер хоче бачити кількість підтверджень по днях до 09:00. Для прикладу канонічне джерело — таблиця бронювань; число 18 місяців і час 09:00 — навчальні вимоги, не виміряні дані реального продукту. Команда спершу запитує таблиці напряму й вимірює запит на репрезентативній копії. Якщо вимірювання покажуть, що важкий звіт заважає підтвердженню слотів, команда додає окремий денний підсумок. Завдання, яке працює вночі, рахує в ньому бронювання за датою й статусом, оновлює рядки повторно без створення дублікатів і зберігає час останнього обчислення. На сторінці звіту показують, до якого часу враховані зміни. Якщо нічний перерахунок не завершився, менеджер бачить старіший час оновлення, а чергова команда може повторити перерахунок із канонічних записів. Правило дедуплікації, часовий пояс дня та значення скасованого бронювання мають бути визначені явно; інакше швидкий підсумок буде відтворювати неоднозначність вихідних даних.
Матеріалізоване подання зберігає результат запиту між читаннями; його не слід називати синхронним відображенням першоджерела. Свіжість залежить від того, коли команда його оновлює. Якщо дані потрібні для рішення з юридичним чи фінансовим наслідком, покажіть межу актуальності або виконайте перевірку за канонічним записом. Не припускайте, що дані з двох систем утворюють одну атомарну транзакцію лише тому, що на екрані стоять поруч.
Джерела до підглави 16.4: матеріали звірено 23 вересня 2026 року. PostgreSQL 18: матеріалізовані подання пояснюють, що результат збережено й оновлюється окремою командою; PostgreSQL 18: EXPLAIN описує план запиту й оцінки вартості. Розмежування операційних та аналітичних задач і приклад звіту — навчальний синтез; схема зі свіжістю і відновленням має бути вимогою конкретного продукту.
16.5. Індекси, сховище і вимірювання запиту
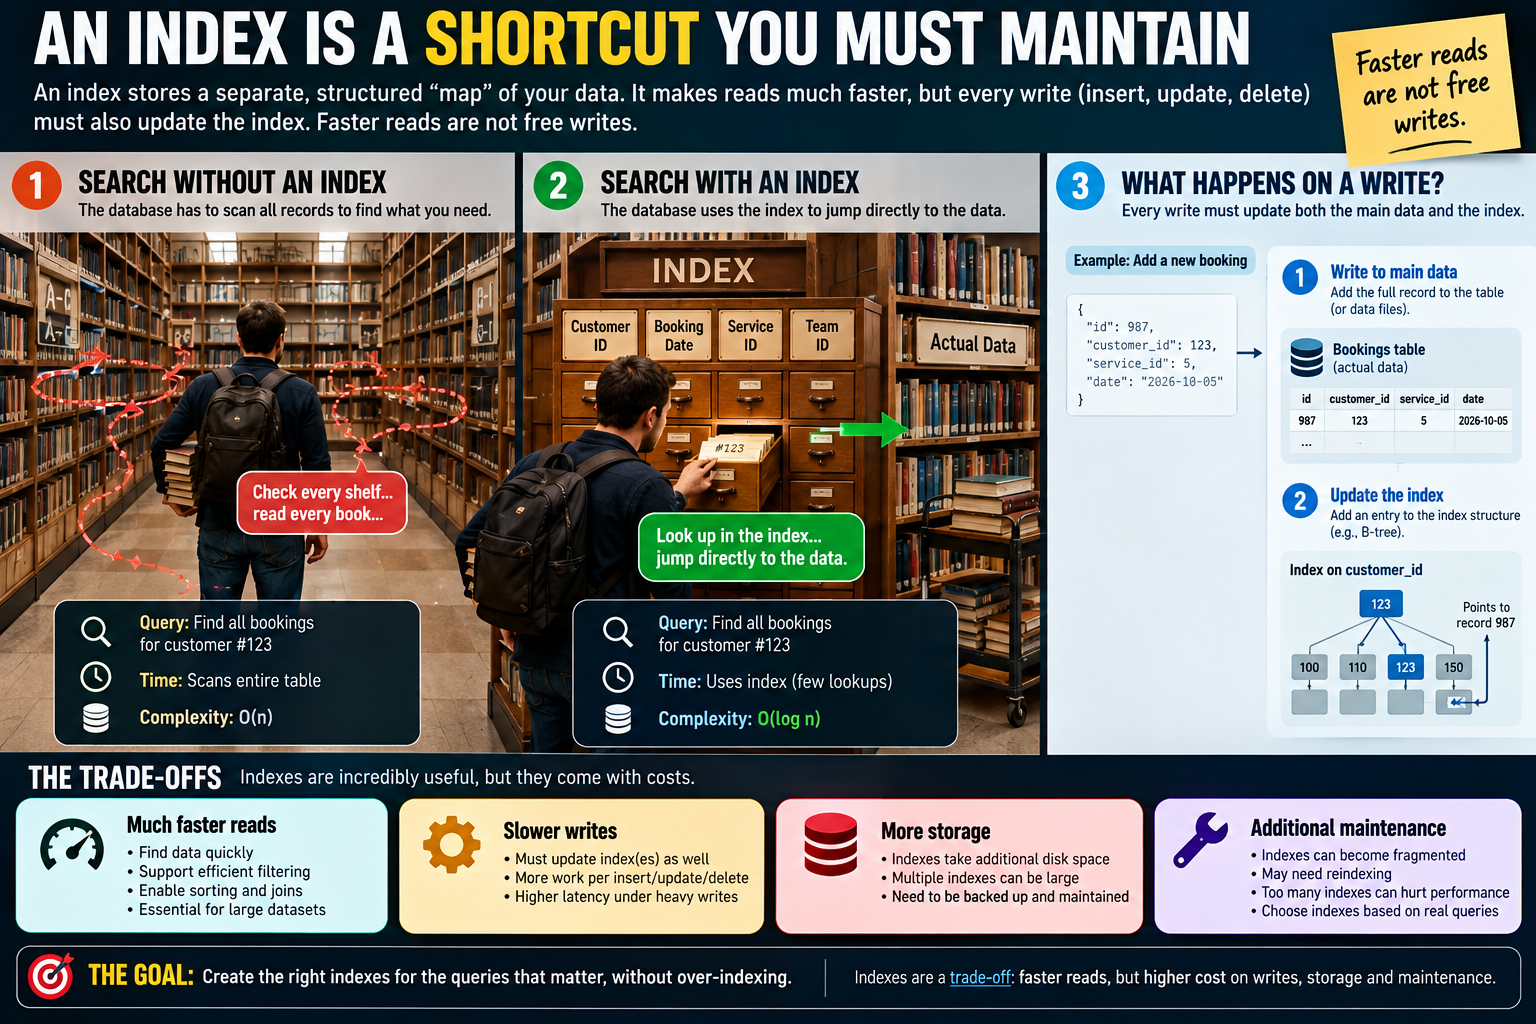
Індекс — допоміжна структура для пошуку рядків без повного перегляду всієї таблиці в кожному запиті. B-tree — збалансоване дерево пошуку; в PostgreSQL це типовий вид індексу, придатний для багатьох перевірок рівності, діапазону та впорядкування. Індекс не змінює сенс даних і не робить будь-який запит миттєвим: його вигода залежить від форми предиката, кількості рядків, розподілу значень, пам’яті та плану, який оптимізатор обрав для конкретного запиту.
Завершений приклад. Сторінка історії бронювань шукає рядки одного клієнта від обраної дати й показує їх від найновішого до найстарішого:
SELECT booking_id, starts_at, status
FROM bookings
WHERE customer_id = 42
  AND starts_at >= TIMESTAMPTZ '2026-01-01 00:00:00+00'
ORDER BY starts_at DESC
LIMIT 50;
Команда спершу дивиться на кількість рядків, частоту запиту та план; вона не додає індекси до кожного поля про всяк випадок. Для пошуку за клієнтом і діапазоном часу може підійти складений B-tree індекс:
CREATE INDEX bookings_customer_time_idx
ON bookings (customer_id, starts_at DESC);
Порядок полів важливий для складеного індексу: у PostgreSQL B-tree зазвичай найкраще обмежує діапазон, якщо умова використовує ліві провідні стовпці; документація 18 також описує випадки, де пропуск першого стовпця може скористатися skip scan. Тому не перетворюйте правило про провідний стовпець на універсальне твердження — перевірте версію, дані й план. Індекс зберігає додаткові сторінки, уповільнює зміни, які мають його підтримати, і не гарантує використання оптимізатором.
План можна побачити командою EXPLAIN. Вона показує вибрані операції й оцінки, а EXPLAIN ANALYZE справді запускає запит і вимірює його виконання. Вимірюйте репрезентативні дані, а не один щасливий запуск на порожній базі; для змінювального запиту враховуйте, що варіант із ANALYZE виконає його. Перевіряйте рядки, які оцінив планувальник, порівняно з фактично прочитаними, а також читання з диска й буферів. Жодне дерево індексів саме по собі не доводить, що цільова сторінка вкладки стане швидшою.
Індексне сховище також має інші конструкції. LSM (Log-Structured Merge-tree — дерево злиття журналів) у первинній роботі O’Neil та співавторів описане як спосіб організувати пошук у середовищі з інтенсивними вставками через накопичення й злиття структур. Це переносить частину витрат на фонові злиття, читання та керування місцем. B-tree і LSM не є оцінкою «застаріле проти сучасного»: вибір залежить від розподілу читань і записів, обсягу даних, затримки, відновлення та конкретної реалізації двигуна.
Рядкове сховище тримає поля одного запису близько одне до одного; це часто зручно для вставлення й читання повного бронювання. Стовпцеве сховище групує значення за полем і може зменшити обсяг читання, коли аналітичний запит сканує багато рядків, але бере лише кілька стовпців. У форматі Parquet дані всередині групи рядків зберігаються за стовпцями, а статистика допомагає пропускати групи, що не відповідають фільтру. Це не загальне прискорення будь-якого запиту: читання повних записів, часті малі оновлення, розмір групи та компресія змінюють результат. На невеликому обсязі рядкової таблиці може бути достатньо простого індексу або запиту без окремого аналітичного формату.
Джерела до підглави 16.5: матеріали звірено 23 вересня 2026 року. PostgreSQL 18: вступ до індексів, багатостовпцеві індекси та EXPLAIN; Patrick O’Neil та співавтори, The Log-Structured Merge-Tree, Acta Informatica, 1996; DuckDB, Querying Parquet with Precision. Приклад індексу треба перевіряти за фактичним планом і конкретною версією бази; стаття про LSM описує конструкцію, а не обіцяє однакову перевагу в кожному навантаженні.
16.6. Транзакція і межі гарантій
ACID розшифровується як Atomicity, Consistency, Isolation, Durability — атомарність, узгодженість, ізоляція та довговічність. Це чотири властивості транзакційної моделі, але конкретна гарантія залежить від двигуна, його параметрів і того, де закінчується транзакція.
- Атомарність: група змін фіксується разом або скасовується разом. Підтвердження бронювання та його позиції не мають лишитися частково записаними.
- Узгодженість: транзакція має перевести дані з одного допустимого стану в інший. База може перевірити задані зовнішні ключі й обмеження, але не вгадає приховане правило бізнесу, якого розробник не записав.
- Ізоляція: конкурентні операції взаємодіють за певним рівнем ізоляції. Назва «транзакція» не означає, що всі можливі перегони автоматично зникають.
- Довговічність: після успішного фіксування система обіцяє зберегти результат у межах документованих налаштувань. Політика запису журналу, обладнання, реплікація та аварійне перемикання впливають на те, що можна пережити.
Завершений приклад однієї транзакції. Марта підтверджує консультацію та переклад. Сервер розпочинає транзакцію; резервує один слот; створює бронювання; фіксує дві обрані послуги та ціну кожної на момент купівлі; записує стан «підтверджено»; тоді фіксує транзакцію. Якщо під час запису другої послуги порушується обмеження, сервер скасовує всю транзакцію: слот не лишається заброньованим без повного складу покупки. Повідомлення електронною поштою не стає частиною транзакції реляційної бази, тож окремо треба вирішити, як безпечно повідомити клієнта після фіксації. Цей розрив ми розберемо в підглаві про outbox.
Порівнюйте транзакцію з вимогою: які саме записи вона охоплює; хто ще може змінити ті самі факти; чи потрібна послідовна картина; що робити з відмовою; чи є зовнішній виклик між початком та кінцем. Не тримайте транзакцію відкритою, поки людина заповнює форму або поки сервіс віддаленого партнера відповідає мережею. Транзакційна база може захистити атомарність власних записів, але не перетворює мережеві системи на одну спільну базу. Для наступної зовнішньої дії потрібен окремий план відновлення, наприклад outbox у підглаві 16.13. Джерела до підглави 16.6: матеріали звірено 23 вересня 2026 року. PostgreSQL 18: транзакції в навчальному посібнику, рівні ізоляції і high availability та асинхронна реплікація. ACID тут подано як навчальну рамку; не переносіть гарантії PostgreSQL 18 на інший продукт або налаштування без перевірки їх документації.
16.7. Конкурентний доступ: приклад останнього місця
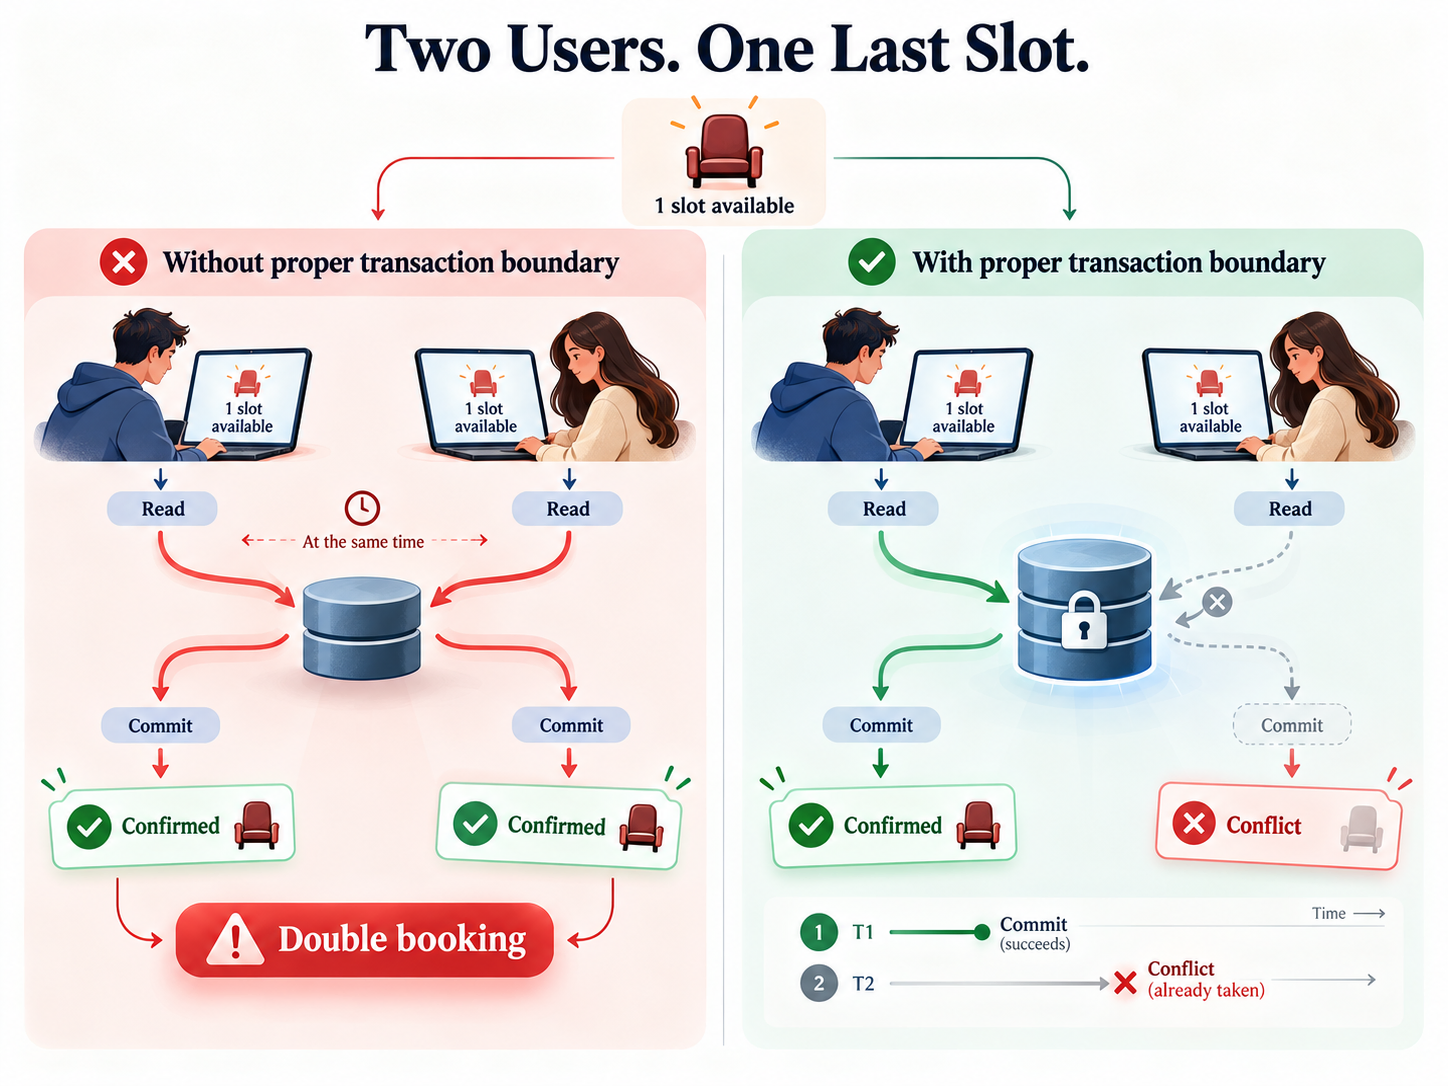
Запити SQL дають інструменти для обмежень і транзакцій, але дві коректні окремо операції можуть конфліктувати, якщо змінюють той самий факт одночасно. Стан, перевірений лише в застосунку, може застаріти, поки запит іде мережею. Перевірка та зміна мають бути атомарними або захищеними обмеженням чи блокуванням у сховищі.
Повний сценарій гонки. У слота S-9 місткість 20, а підтверджено 19 місць. Марта й Олег майже одночасно відкривають останнє місце. Обидва браузери показують доступність 1 — це однакова стара картина, а не право кожного на місце. Якщо сервер окремо читає лічильник, а потім без повторної умови додає бронювання, обидві операції можуть побачити 19 і збільшити лічильник до 21.
Одна навчальна реалізація PostgreSQL використовує умовне оновлення:
WITH reserved AS (
    UPDATE slots
    SET confirmed_count = confirmed_count + 1
    WHERE slot_id = 9
      AND confirmed_count < capacity
    RETURNING slot_id
)
INSERT INTO bookings (slot_id, customer_id, status)
SELECT slot_id, 42, 'confirmed'
FROM reserved
RETURNING slot_id;
Приклад припускає, що capacity і confirmed_count оголошені NOT NULL. Сам CHECK не відхиляє NULL: умова з невідомим результатом не є хибною. Після перевірки й виправлення наявних рядків схема додатково не дозволяє перевищити місткість:
ALTER TABLE slots
ADD CONSTRAINT slots_capacity_not_exceeded
CHECK (confirmed_count >= 0 AND confirmed_count <= capacity);
У першого клієнта умовне оновлення змінює 19 на 20, після чого той самий оператор вставляє бронювання. Конкурентне оновлення цього рядка чекає. За READ COMMITTED у PostgreSQL друга транзакція повторно перевіряє умову на актуальному рядку; місткість уже вичерпана, тому вона не вставляє бронювання й повертає нуль рядків. Застосунок пропонує інший слот. Якщо вставлення не проходить, оновлення лічильника також відкочується.
Застосунок повідомляє про успіх лише тоді, коли оператор повернув бронювання. Якби оновлення та вставлення були окремими командами, їх треба було б охопити спільною транзакцією й відкотити разом за помилки. Також визначте, чи лічильник є канонічним станом або похідною сумою і як його відновити. Інші схеми можуть використовувати унікальне обмеження, блокування чи SERIALIZABLE; гарантії залежать від бази й структури даних.
Інша аномалія — втрачена зміна. Марта та Олег відкривають ту саму версію профілю; Марта змінює телефон, Олег — мову. Якщо обидва надсилають цілий старий об’єкт, останній запис може повернути телефон до попереднього значення. Якщо кожен оновлює лише своє поле, конфлікту може не бути. Коли повна заміна рядка потрібна, оптимістичний контроль версії виявляє, що дані змінилися після читання:
UPDATE customers
SET phone = $1, version = version + 1
WHERE customer_id = $2 AND version = $3
RETURNING version;
У фрагменті $1, $2 і $3 — параметри, які застосунок передає окремо від тексту запиту. Якщо повернуто нуль рядків, версія вже змінилася: застосунок читає новий стан і пропонує злити зміни або повторити дію після перевірки; він не перезаписує новіше значення мовчки. Усі шляхи запису мають збільшувати version, інакше контроль не помітить стороннього оновлення. Песимістичне блокування корисне для короткої критичної ділянки, коли чекати конкурента дешевше за повторне злиття; воно довше утримує ресурс і може збільшити затримки. Вибір залежить від частоти конфліктів та ціни відмови.
За REPEATABLE READ — рівня повторюваного читання — транзакція PostgreSQL читає стабільний знімок, тож повторне читання не покаже нові зафіксовані зміни інших транзакцій. Однак це не усуває кожну аномалію серіалізації. Наприклад, у клініці мають чергувати щонайменше двоє лікарів. Дві паралельні транзакції бачать, що чергують обоє; кожна вимикає чергування лише для свого лікаря. Вони змінюють різні рядки, тому можуть обидві завершитися, хоча після них не лишається жодного чергового. Це «перекіс запису»: кожна окрема зміна виглядає допустимою на своєму знімку, але спільний інваріант порушено. Для цього правила потрібен механізм, який серіалізує спільне рішення: наприклад, блокування спільного рядка розкладу або рівень SERIALIZABLE із повтором усієї транзакції за контрольованої помилки. Обмеження підходить лише тоді, коли схема дозволяє точно виразити цей інваріант; звичайне PostgreSQL CHECK перевіряє новий чи оновлений рядок і не гарантує умову на кшталт «не менше двох лікарів чергують» між різними рядками.
За SERIALIZABLE — серіалізованого рівня — база може виявити конфлікт і перервати одну транзакцію з помилкою серіалізації. Клієнт має за обмежених умов повторити всю логічну транзакцію з її перевірками, а не тільки останній SQL-оператор. Повтор потребує межі спроб, затримки та безпечної поведінки при втраті відповіді. Якщо назовні вже пішов лист чи платіжний запит, повтор усієї операції може зробити побічну дію вдруге; це потребує ключа ідемпотентності або окремого журналу наміру, до якого ми повернемося далі.
Джерела до підглави 16.7: матеріали звірено 23 вересня 2026 року. PostgreSQL 18: застосункові перевірки узгодженості, рівні ізоляції транзакцій, явне блокування, обмеження CHECK та їхня межа між рядками. Приклад умовного UPDATE навмисно прив’язаний до PostgreSQL і вимагає перевірити кількість повернених рядків; це не універсальна гарантія синтаксису для всіх баз.
SQL (Structured Query Language — структурована мова запитів) дає інструменти для обмежень і транзакцій, але дві коректні окремо операції можуть конфліктувати, якщо одночасно змінюють той самий факт. Стан, перевірений лише у прикладному коді перед записом, застаріває, поки запит іде мережею. Перевірка та зміна мають бути атомарними або захищеними обмеженням чи блокуванням на рівні сховища.
У першого клієнта умовне оновлення змінює 19 на 20, після чого та сама команда вставляє бронювання. Поки команда не завершилася, конкурентне оновлення того самого рядка може зачекати. За рівня ізоляції READ COMMITTED (читання зафіксованих змін) PostgreSQL після очікування повторно перевіряє умову на актуальному рядку: умова «confirmed_count < capacity» уже хибна, тому друга команда не вставляє бронювання й повертає нуль рядків. Застосунок повідомляє, що місце щойно зайняли, та пропонує інший слот. Це один атомарний оператор: якщо вставлення бронювання не проходить, зміна лічильника теж не фіксується.
Застосунок перевіряє, чи команда повернула рядок, перш ніж повідомляти про успіх. Умовне оновлення та вставлення відбуваються одним оператором; окремі SQL-оператори вимагали б охопити обидві зміни спільною транзакцією й відкочувати її, якщо оновлення не знайшло місця або вставлення завершилося помилкою. Перевірте також, чи є лічильник канонічним станом або похідною сумою записів, і як відновити його після помилки. В інших моделях можливі обмеження унікальності, блокування рядка чи серіалізована транзакція; їхня семантика залежить від конкретної бази й схеми.
16.8. Час, аудит і строк зберігання
Час у даних відповідає щонайменше на два різні запитання. «Коли саме сталася подія?» потребує однозначної часової точки. «Який місцевий час обрав клієнт?» потребує зони та правил календаря. UTC (Coordinated Universal Time — Всесвітній координований час) допомагає зберігати й порівнювати моменти подій між серверами; календарна зона, наприклад Europe/Oslo, потрібна, щоб тлумачити місцевий розклад і переходи літнього часу. Самого рядка «02:30» недостатньо, якщо дата потрапляє на повторену або пропущену годину.
Розділяйте час події, час приймання та час оброблення. Партнер міг створити подію вчора, ваш сервіс отримати її сьогодні, а черга обробити ще пізніше. Поля occurred_at, received_at і processed_at мають різний зміст; одне timestamp не відповість на всі питання. У PostgreSQL тип timestamptz зберігає момент часу й показує його з урахуванням налаштування часової зони сеансу; він не зберігає початкове ім’я зони як частину значення. Якщо важливо відтворити правило розкладу, збережіть назву зони окремо.
Зберігання — це також схема даних. До запуску визначте, які факти мусять лишитися для розрахунку, підтримки й аудиту; які поля можна видалити або знеособити; кому доступний журнал; як строк застосовується до копій, експорту й резервних матеріалів; як довести, що процедуру виконано. Застосовні юридичні строки залежать від юрисдикції та продукту, тож їх має перевірити відповідальний фахівець. Не обіцяйте, що видалення рядка з основної таблиці миттєво стирає його з усіх реплік і резервних копій.
Soft delete — логічне видалення — позначає запис як видалений або неактивний, не прибираючи його рядок одразу. Це допомагає зберегти посилання чи відновити помилкову дію, але змінює запити й обмеження: звичайний список має приховати такі записи, а унікальна назва може й далі залишатися зайнятою. Логічне видалення не дорівнює фізичному стиранню чи знеособленню. Тримайте окремо поточний стан і історію подій лише тоді, коли продуктові вимоги справді потребують історії; рядок зі статусом «скасовано» не відтворює автоматично всі попередні зміни.
Вигаданий приклад аудиту переходу між командами. У навчальному сайті футбольної статистики умовна офіційна ліга постачає реєстр клубної належності гравців. За погодженим контрактом саме цей канал є авторитетним для факту реєстрації переходу; сайт відповідає за свої внутрішні профілі та відповідність зовнішніх ідентифікаторів внутрішнім. У реальній інтеграції команда окремо перевіряє автентифікацію каналу, версію схеми та правила виправлення; авторитетність джерела стосується лише фактів, визначених його контрактом. Усі імена й події далі вигадані. Стабільні ключі — player_id=pl_042, team_id=tm_A і team_id=tm_B; назви «Команда A» та «Команда B» можуть змінитися або мати різні переклади, тому їх не використовують як ключі. Джерело надіслало event_id=evt-2026-0042, revision=1: гравець переходить із tm_A до tm_B з effective_at 2026-08-01T00:00:00Z. Сайт прийняв цю версію 2026-08-02T04:12:00Z і зберіг observed_at окремо від effective_at. Якщо джерело надає тільки календарну дату без часу, система зберігає effective_date і точність календарної дати, а effective_at лишає невизначеним; вона не вигадує опівніч як точний момент.
Через два дні той самий event_id приходить як revision=2: джерело виправляє effective_at на 2026-08-03T00:00:00Z; портал спостерігає виправлення 2026-08-04T04:12:00Z. Це не другий перехід. Журнал приймання зберігає обидві версії, джерело, номер ревізії, час спостереження та digest вмісту, нормалізованого за контрактом джерела; канонічний запис переходу вказує на прийняту актуальну ревізію. Тому можна відповісти і «який факт зараз підтверджує джерело?», і «що портал знав 2 серпня?». Повтор того самого кортежу (source_system, event_id, revision) з тим самим digest нормалізованого за контрактом джерела вмісту є no-op: повторна доставка не створює нового факту. Якщо кортеж збігається, але digest інший, обидва спостереження зберігають як конфлікт для звірки; прийняту версію, канонічний перехід і проєкцію не змінюють до рішення за контрактом джерела.
Поточний склад команди — похідна проєкція канонічної історії, а не єдине місце збереження факту. У цьому вигаданому продукті гравець має не більш як одну активну клубну реєстрацію одночасно; якщо реальний домен допускає позики чи кілька паралельних реєстрацій, сам інваріант і ключ проєкції треба змінити. Перебудова для player_id=pl_042 застосовує прийняті переходи за effective_at та визначеним правилом конфліктів; після виправлення вона заново обчислює стан на потрібну дату й оновлює рядок гравця за стабільним player_id. Якщо ланцюг від tm_A до tm_B не узгоджується з попередньою належністю або бракує зіставлення зовнішнього ID, система показує розбіжність для перевірки, а не виводить команду з імені. Доступ до сирого вмісту, строки його зберігання та видимість аудиторського журналу задають окремо; digest нормалізованого вмісту й посилання на джерело часто достатні для діагностики без копіювання зайвих даних у загальний лог. Джерела до підглави 16.8: матеріали звірено 23 вересня 2026 року. PostgreSQL 18: типи дати й часу описують timestamptz і часову зону виведення; PostgreSQL 18: логічне декодування пояснює читання змін із журналу відновлення. Приклад переходу між командами вигаданий і не описує реальну лігу чи постачальника; правила зберігання і приватності визначаються окремо для юрисдикції та продукту.
16.9. Реплікація, висока доступність і резервна копія
Реплікація передає зміни з одного вузла до іншого, часто щоб пережити відмову або розподілити читання. Вона не робить копію незалежною від логічної помилки: помилкове видалення може так само поширитися. Резервна копія має іншу мету — повернути систему до придатного стану після втрати, помилки чи небажаної зміни. Її цінність підтверджує лише перевірене відновлення, а не зелений індикатор успішного копіювання.
За асинхронної реплікації основний вузол може підтвердити запис до того, як резервний його застосував. Тоді резервний вузол короткий час показує старіше значення; аварійне перемикання також може втратити ще не перенесену зміну. Синхронний режим змінює затримку й доступність запису за втрати вузла або зв’язку. Назви режимів треба читати у документації продукту: «реплікація ввімкнена» не є доказом конкретного допустимого вікна втрати.
Завершений приклад застарілого читання. О 10:05 Марта змінила адресу в основній базі, яка підтвердила запис. Профіль одразу читає резервну репліку; вона ще не застосувала зміну й показує стару адресу. Це очікувана затримка асинхронної репліки, а не доказ, що база відкинула запис. Якщо екран має негайно показати власну зміну, застосунок читає авторитетний вузол або іншим способом гарантує читання після запису; для звіту, де коротка затримка допустима, можна читати репліку й показати час актуальності. Якщо клієнт на підставі старої адреси повторно редагує профіль, оптимістична версія рядка допомагає не затерти новішу зміну. Команда визначає цю поведінку до того, як користувач зіткнеться з нею; сама репліка лишається корисною для доступності й масштабування читання.
Історичний збій GitLab у січні 2017 року показує різницю між резервною копією та реплікою. У постмортемі компанія розділяє два проміжки: GitLab.com був недоступний близько 18 годин, а відновлення сервісу тривало понад 18 годин. На той час резервні копії не спрацьовували, а репліка не була резервною копією для аварійного відновлення. Це свідчення опубліковане самою GitLab і описує систему та процеси того часу; воно не характеризує сучасну інфраструктуру компанії. Практичний урок із конкретних дій постмортему: контролювати не тільки завершення завдання резервування, а й тривалість відновлення на чистому середовищі, доступність журналу транзакцій і відповідальних за інцидент.
Логічна реплікація PostgreSQL може передавати початковий знімок і наступні зміни, але не переносить визначення схеми автоматично. Окремий споживач має розуміти, чи отримав нову структуру, як переживає зміну порядку полів і як відновити пропущений інтервал. PITR (point-in-time recovery — відновлення до заданого моменту) поєднує базову копію з архівом журналів транзакцій, але потребує справжньої перевірки процедури.
Джерела до підглави 16.9: матеріали звірено 23 вересня 2026 року. PostgreSQL 18: висока доступність і реплікація, логічна реплікація і відновлення до заданого моменту; GitLab, постмортем збою бази даних 31 січня 2017 року. Звіт GitLab є самоописом історичного інциденту. Його не можна використовувати як доказ стану поточної інфраструктури.
16.10. Розбиття таблиць і розподіл даних між вузлами
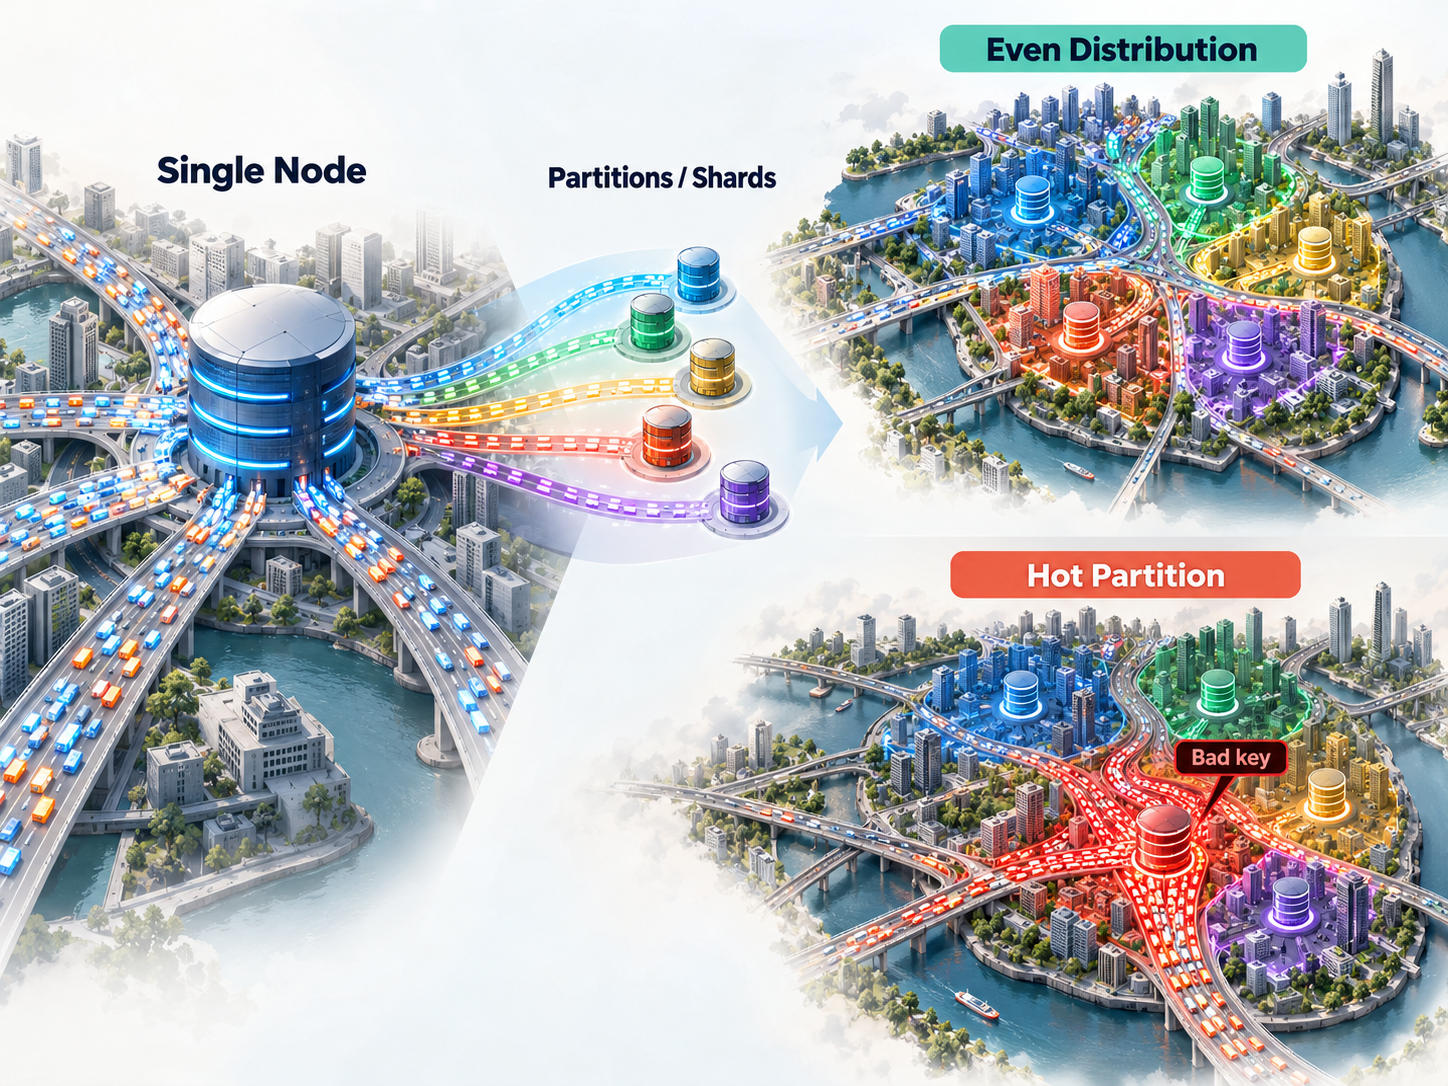
Партиціювання розділяє одну логічну таблицю на менші фізичні частини за ключем, наприклад за місяцем дати. Це може звузити ділянку, яку читає запит, і полегшити керування старими діапазонами. Воно не зменшує автоматично всю роботу запиту: якщо читання не обмежене ключем партиціювання, рушій може звернутися до багатьох частин. У PostgreSQL спосіб формулювання обмежень і правило унікальності можуть залежати від ключа партиціювання; перед зміною дизайну прочитайте обмеження конкретної версії.
Завершений приклад історії. Навчальний сервіс має бронювання за 6 років, і виміряний щомісячний звіт читає тільки один місяць. Команда випробовує партиціювання таблиці за місяцем створення й перевіряє план цього звіту. Перш ніж залишити схему, вона також перевіряє пошук за клієнтом без дати, звіт за всі роки, перевірку дубльованого зовнішнього номера, перебудову резервної копії та видалення строку зберігання. Якщо ці операції тепер потребують переглянути всі партиції або глобальну унікальність не можна гарантувати заданою схемою, команда має змінити ключ, індекс або спосіб ідентифікації. Вона не створює щомісячні партиції лише тому, що календар природно ділиться на місяці.
Шардінг розподіляє різні ключі між кількома окремими вузлами. Це може збільшити сукупну місткість, але вимагає правила маршрутизації, міграції ключів, балансування, контролю дисбалансу й поведінки запиту, який охоплює кілька вузлів. Неправильний ключ створює гарячий шард; зміна ключа може вимагати переміщення значної частини даних. Транзакція між двома шарами також має окрему ціну. Поки вимірювання показують, що одна база відповідає вимогам, складність розподілу не є безкоштовним запасом на майбутнє.
Повний план для команди має містити тестовий розподіл даних, критерій переходу, спосіб перевірити коректність розміщення, план копіювання чи перерозподілу, спостереження за гарячими ключами, відкат і спосіб відновлення. Рішення про сегментацію за організацією чи клієнтом також має пройти контроль ізоляції: помилка маршрутизації може відкрити дані не того власника.
Джерела до підглави 16.10: матеріали звірено 23 вересня 2026 року. PostgreSQL 18: декларативне партиціювання описує pruning, межі та обмеження ключів. Для розподілених даних — Designing Data-Intensive Applications, 2nd edition — зміст. Чи потрібне партиціювання або шардінг, визначають вимоги й вимірювання конкретного продукту.
16.11. Відмова мережі, тайм-аути, годинники й повтори
Тайм-аут відповідає на запитання «скільки клієнт чекав», а не «чи виконав сервер операцію». Сервер міг прийняти платіж або створити бронювання й не встигнути надіслати відповідь. Через втрату відповіді клієнт бачить помилку, хоча зміна вже сталася. Тому повтор після тайм-ауту може створити дублікат, якщо команда не спроєктувала перевірку ідентичності запиту.
Клієнт може повторити тимчасову помилку з обмеженою кількістю спроб, зростаючими інтервалами та випадковим розкидом затримки, щоб багато клієнтів не вдарили сервіс разом. Повтор має вкладатися у загальний строк запиту, враховувати межі партнера та розрізняти тимчасову помилку від відхиленої операції. Безмежний повтор навантажує вже несправну залежність. Ідемпотентний ключ, як його документує провайдер, допомагає повторно запросити ту саму логічну дію, але не є дозволом змінювати її параметри під тим самим ключем.
Настінний годинник може перескочити через корекцію часу, часову зону чи зміну літнього часу. Для тривалості тайм-ауту процес використовує монотонний відлік, якщо мова й платформа надають його; календарний timestamp лишається для журналу та людей. На кількох машинах сусідні події можуть мати однаковий чи переставлений час. Якщо причинний порядок критичний, команда має зберігати послідовність від джерела, номер версії чи окремий порядок подій, а не виводити його з настінного годинника. Системи з фізичними годинниками та межами невизначеності, як Spanner, відкрито документують цю складність замість прикидатися, що всі годинники точні.
Завершений приклад невизначеної відповіді й відновлення. Партнер надсилає навчальну webhook-подію про оплату з вигаданим ідентифікатором event_781. Сервер в одній локальній транзакції реєструє зовнішній ідентифікатор і змінює канонічний стан платежу; з’єднання обривається до успішної відповіді класу 2xx. Партнер не знає, чи запис зафіксований, і повторює подію. Унікальне обмеження на пару «партнер, ідентифікатор події» пов’язує повтор із раніше збереженим результатом, тому сервер підтверджує приймання знову, не нараховуючи платіж удруге. Якщо сервер упав до фіксації транзакції, не зберігся ні запис отримання, ні зміна платежу, тож повтор запускає всю операцію. Якщо після фіксації треба виконати окреме завдання, наприклад видати доступ, транзакція також створює запис у outbox; відновлений працівник бере незавершену подію, а зовнішній виклик повторює зі стабільним ключем ідемпотентності, якщо партнер його підтримує. Коли результат зовнішньої дії невідомий і ключа немає, спершу звірте стан у партнера, а не створюйте нову дію навмання. Якщо дублікати надходять паралельно, унікальне обмеження або атомарна реєстрація визначають одного переможця. Це обмеження не доводить автентичність платника: її перевіряють за окремим контрактом підпису та ідентичності партнера.
Джерела до підглави 16.11: матеріали звірено 23 вересня 2026 року. PostgreSQL 18: транзакції в навчальному посібнику та обмеження унікальності підтверджують атомарність локальних змін і роль унікального ключа; Stripe, Idempotency and retries та документація ідемпотентних запитів описують повтори за стабільним ключем; Google Research, Spanner: Google’s Globally-Distributed Database розглядає межі годинників у розподіленій системі. Приклад webhook є навчальним; формати подій і строки повтору треба брати з контракту конкретного партнера.
16.12. Узгодженість, мережеві розділення та кворум
CAP — Consistency, Availability, Partition tolerance (узгодженість, доступність і стійкість до розділення мережі) — назва результату про поведінку розподіленого читання й запису під час мережевого розділення. У формальній постановці Gilbert і Lynch розглядають лінеаризовану узгодженість спільного об’єкта та доступність запитів до вузлів, які не відмовили. Якщо мережевий розрив уже стався, неможливо водночас гарантувати кожному запиту відповідь і те, що кожен вузол поводиться як одне послідовне актуальне сховище. Це не побутове правило «вибери будь-які два з трьох»: розділення є умовою збою, а конкретний компроміс видно саме під час нього.
Слово consistency в CAP не тотожне властивості Consistency моделі ACID (Atomicity, Consistency, Isolation, Durability — атомарність, узгодженість, ізоляція та довговічність) у підглаві 16.6. Там ідеться про допустимий стан транзакції згідно з обмеженнями; тут — про формальну поведінку операцій у розподіленій системі. Так само availability не означає лише «процес працює» чи «є сторінка стану»: у формальній моделі кожен запит до доступного вузла має завершитися відповіддю. Назвіть потрібну гарантію продукту — наприклад, чи може підтвердження бронювання відбутися в обох ізольованих дата-центрах — замість того, щоб позначати всю систему одним словом «узгоджена».
Лінеаризоване читання поводиться так, ніби завершені операції сталися в одному глобальному порядку між початком і відповіддю кожної операції; після підтвердженого запису наступне читання не має показати старіший стан. За eventual consistency — узгодженості, що настає зрештою — копії можуть деякий час відрізнятися, але за припущення, що нові зміни припинилися й поширення відновилося, мають зблизитися до спільного стану. Це не встановлює межі затримки й не означає, що будь-який конфлікт буде злитий бажаним для бізнесу способом. Якщо інтерфейс читає профіль з репліки, його треба спроєктувати навколо допустимого проміжку застарілості; якщо читає результат оплати — така затримка може бути неприйнятною.
Консенсус допомагає вузлам погодити спільний порядок значень або записів за визначеними припущеннями про мережу й кількість відмов. Raft — опублікований алгоритм керування реплікованим журналом: учасники обирають лідера, а запис може стати узгодженим після підтвердження потрібною більшістю. Це не робить будь-яку операцію миттєвою та не дозволяє меншості безпечно приймати незалежні конфліктні записи, якщо система має зберігати єдиний порядок.
Завершений приклад із розривом мережі. Система бронювання має три вузли й не може дозволити двом людям отримати те саме останнє місце. Після втрати зв’язку між вузлами перша частина бачить два вузли, а друга — один. У схемі, де журнал просувається лише після більшості, пара може продовжити запис після виборів і кворумного підтвердження; ізольований вузол не підтверджує цей запис. Частина сервісу може відповісти тимчасовою помилкою або чекати, а клієнту треба показати зрозумілий повторний стан. Схема, що натомість дозволяє кожній половині записувати локально, може покращити доступність для кожної частини, але пізніше мусить розв’язати два підтвердження того самого місця. Власник продукту має вибрати, який наслідок прийнятний, а інженер має зафіксувати поведінку при відновленні зв’язку.
Кворум — поріг голосів або відповідей, визначений конкретним протоколом; сама наявність слова не гарантує свіжого читання чи довговічного запису. Для кворумних читань і записів перевіряють, чи перетинаються набори реплік, як версіонуються значення, як виявляється конфлікт, коли підтвердження вважають стійким і що відбувається при втраті більшості. Формулу з кількості реплік не можна вирвати з правил конкретного сховища.
Джерела до підглави 16.12: матеріали звірено 23 вересня 2026 року. Seth Gilbert і Nancy Lynch, Brewer’s conjecture and the feasibility of consistent, available, partition-tolerant web services, ACM (Association for Computing Machinery) SIGACT (Special Interest Group on Algorithms and Computation Theory) News, 2002; Diego Ongaro і John Ousterhout, In Search of an Understandable Consensus Algorithm, USENIX Annual Technical Conference (ATC), 2014; Amazon, Dynamo: Amazon’s Highly Available Key-value Store. Приклад трьох вузлів є навчальним; реальні пороги та поведінку треба перевіряти у специфікації обраного протоколу.
16.13. Розподілені операції, outbox та ідемпотентність
Розподілена транзакція намагається погодити одну логічну дію між кількома незалежними ресурсами, наприклад між локальною базою та брокером повідомлень. Двофазна фіксація (Two-Phase Commit, 2PC) просить учасників спершу підготуватися, а потім фіксує результат. Учасники та координатор мають підтримувати цей протокол; відмова координатора, затриманий учасник і обмеження провайдера впливають на доступність. Не називайте звичайний мережевий виклик через HTTP (Hypertext Transfer Protocol — протокол передавання гіпертексту) усередині транзакційної функції атомарним записом у два сервіси.
Transactional outbox — «транзакційний вихідний журнал» — зберігає подію в тій самій базі й транзакції, що й бізнес-зміна. Окремий видавець читає вже зафіксовані рядки й доставляє їх у брокер. Якщо база відкотилася, рядок події також відкотиться; якщо процес упав після доставки, але до позначки «відправлено», подія може прийти повторно. Тому споживачеві потрібна власна ідемпотентність: повтор однієї події не має вдруге створити бізнес-ефект. Outbox зменшує проблему подвійного запису, а не гарантує одноразовий зовнішній ефект.
Повний приклад події бронювання. Сервіс у транзакції підтверджує бронювання B-23 і додає в таблицю outbox подію booking_confirmed з незмінним event_id, ідентифікатором бронювання, його версією та часом. Після фіксації видавець читає подію й надсилає її поштовому сервісу. Якщо відповідь брокера губиться, видавець повторює доставку з тим самим event_id. Споживач має таблицю processed_events з унікальністю за назвою споживача та event_id. Він реєструє подію й створює завдання сповіщення в одній локальній транзакції; якщо ключ уже є, він повертає попередній результат без другого завдання. Окремий працівник може повторити відправлення листа, а його спроби мають видимий стан і обмеження. Це гарантує контрольований повтор оброблення в межах цих таблиць, але зовнішній поштовий провайдер усе ще може не сказати, чи лист прийнято під час обриву зв’язку. Якщо провайдер підтримує ключ ідемпотентності, передавайте стабільний ключ згідно з його контрактом.
«Exactly-once» (оброблення рівно один раз) не є універсальною властивістю повідомлення через довільну мережу: відправник може не знати, чи отримувач уже зафіксував ефект. Apache Kafka описує транзакційне оброблення в межах Kafka та умови узгодження позиції читача з новими записами в топіках; для зовнішньої бази потрібна співпраця цієї бази або ідемпотентна операція. Спершу уточніть область гарантії: виробник і топік, читання й запис у Kafka, оновлення однієї реляційної БД чи реальна дія партнера. Для довгої бізнес-послідовності в кількох сховищах часто розглядають saga — низку локальних транзакцій із явними діями компенсації; компенсація не завжди може буквально скасувати вже надіслане повідомлення чи отриману послугу.
Джерела до підглави 16.13: матеріали звірено 23 вересня 2026 року. AWS (Amazon Web Services), Prescriptive Guidance: transactional outbox попереджає про повторну доставку та ідемпотентного споживача; Apache Kafka 4.1: дизайн і гарантії доставки обмежує exactly-once власним транзакційним доменом і вимагає співпраці зовнішньої системи. Приклад таблиці вихідних подій і реєстру оброблених подій — навчальна реалізація, а не готова бібліотека.
16.14. Пакетна обробка, повторне обчислення і виправлення історії
Пакетна обробка бере обмежений набір даних, запускає скінченне обчислення й записує результат. На відміну від безперервного потоку, завдання може прочитати вже сформований діапазон за день або місяць. Практичні питання залишаються ті самі: як відокремити повтор, як підтвердити повноту вхідних даних, куди записати частковий результат, як повторити задачу після аварії та як перерахувати минуле після виправлення правила.
MapReduce — програмна модель, де функція map створює проміжні пари ключ-значення, а функція reduce зводить значення для спільного ключа; первинна праця Dean і Ghemawat описує також планування частин, відмови працівників і обмін результатами. Не кожній команді потрібен великий розподілений рушій. Та сама дисципліна корисна для невеликого нічного завдання: розбити вхід за стабільними ключами, зробити кожну частину повторюваною та перевірити підсумок до публікації.
Після приймання пакет перебудовує проєкцію за effective_at або effective_date з точністю, яку надавало джерело. Доставка не визначає порядок подій, а дата не означає вигадану північ. Якщо для однієї події відома лише календарна дата, а інша має точний час того самого дня, але джерело не визначає їхнього порядку, обидві передають на звірку й поточний стан не вгадують. Так само чинять із будь-якими несумісними подіями без визначеного порядку. Для обмеженої історії повний replay простіше перевірити; приростове оновлення дешевше, але потребує контрольної точки й способу скасувати наслідок виправлення. Перед публікацією команда порівнює нову проєкцію зі знімком поточного складу від того самого джерела й моменту. Це знаходить розбіжності в охопленому стані, але не доводить повноту старої історії, якої джерело вже не зберігає.
Пакетні обчислення можуть читати повний історичний набір для відновлення проєкції або лише нові записи для приростового підрахунку. Повний перерахунок простіше звірити, але він має вартість; приростовий дешевший у звичайному циклі, але помилка в його стані може накопичуватися. Зберігайте версію формули, межу вхідних даних, ідентифікатори задач, помилки частин і підсумки звірки. Великі перерахунки виконуйте порціями з повторюваними записами й обмеженим навантаженням на канонічне сховище.
Вигаданий приклад пакетного імпорту та виправлення. Як і в аудиті ревізій у 16.8, умовний сайт щодня імпортує сторінки офіційного реєстру. Для event_id=evt-2026-0042 пакет спершу отримує revision=1, потім ту саму сторінку ще раз через повтор запиту, а згодом — revision=2 з виправленою датою переходу. До публікації пакет перевіряє, що сторінки й контрольні підсумки джерела повні. Він записує кожен отриманий конверт у журнал версій і в одній транзакції додає ще не бачену пару source_system, event_id, revision та оновлює покажчик канонічного переходу, лише якщо нова версія справді замінює попередню за контрактом джерела. Унікальне обмеження на цю пару робить повтор безпечним: той самий кортеж із тим самим digest вмісту, нормалізованого за контрактом джерела, є no-op. Якщо кортеж збігається, але digest відрізняється, обидва спостереження зберігають для звірки; прийняту ревізію й канонічний покажчик не змінюють до рішення за контрактом джерела. Revision=2 лишає revision=1 у журналі, але не додає другого переходу. Пізнє повторне надходження revision=1 не повертає старий стан. Якщо джерело не гарантує монотонних номерів або не визначає зв’язок «виправляє подію», імпортер не вгадує порядок за часом отримання: потрібне правило джерела або ручне розв’язання конфлікту.
Після приймання версій пакет перебудовує проєкцію для зачепленого player_id за effective_at, коли джерело задає точний момент, або за effective_date, коли контракт задає лише календарну дату; порядок доставки не є порядком бізнес-події. День не перетворюється на вигадану північ. Якщо дві несумісні зміни мають точність лише до дня й контракт джерела не задає стабільного порядку, їх залишають для звірки, а поточну проєкцію не вгадують. Якщо подія лише з effective_date і подія з точним effective_at припадають на ту саму календарну дату джерела, а контракт не задає їхнього взаємного порядку, цю пару передають на звірку й поточну проєкцію не вгадують. Для невеликого обмеженого набору простіше повторно скласти історію гравця, перевірити послідовність from_team_id/to_team_id і зробити ідемпотентний upsert одного поточного рядка за player_id; інкрементальне застосування події дешевше, але потребує контрольованого checkpoint і способу скасувати застарілий ефект виправленої версії. Повний replay того самого діапазону не повинен подвоїти переходи або рядки складу. Перш ніж опублікувати нову генерацію проєкції, команда звіряє її зі знімком поточного складу від того самого джерела й моменту: звірка шукає пропущені зовнішні ID, невідомі player_id, зайві записи та різні team_id. Невідповідність позначається з посиланням на вхідну ревізію; ім’я гравця не є автоматичним доказом тотожності. Такий знімок перевіряє поточний стан у межах його охоплення, але не доводить повноту старої історії, якої джерело вже не зберігає.
Джерела до підглави 16.14: матеріали звірено 23 вересня 2026 року. Jeffrey Dean і Sanjay Ghemawat, MapReduce: Simplified Data Processing on Large Clusters, USENIX Symposium on Operating Systems Design and Implementation (OSDI), 2004. Порядок ревізій, повноту знімка та правила виправлення визначає контракт конкретного джерела.
16.15. Потоки подій, позиції читання та навантаження
Потокова обробка читає події, які надходять у часі, зберігає позицію читання й підтримує оновлений результат. Подія має ключ, зміст і порядок, визначений джерелом. У Kafka топік складається з партицій; порядок гарантується всередині окремої партиції, а не автоматично між усіма партиціями. Ключ, за яким маршрутизують події, отже впливає і на паралелізм, і на можливість зібрати записи про одну сутність у порядку.
Offset — позиція наступного повідомлення в партиції, з якої споживач продовжить читання. Група споживачів розподіляє партиції між процесами, але перерозподіл може змінити власника партиції. Споживач, який зберіг offset до запису результату, може втратити результат після аварії; той, хто спершу записав результат, а потім зберіг позицію, може виконати запис повторно. Порядок підтвердження позиції, транзакція та ідемпотентний запис мають відповідати потрібній гарантії.
Завершений приклад потоку статусів. Події бронювання несуть booking_id, номер версії, новий статус і час події. Потік маршрутизується за booking_id, тому переходи для одного бронювання читаються послідовно в межах однієї партиції. Споживач відкидає версію, старшу за вже збережену, і оновлює проєкцію лише якщо нова версія очікувана; несподіваний пропуск відправляє запис до контрольованого відновлення з канонічної таблиці. Якщо процес відстає, команда стежить за найстарішим необробленим часом і довжиною черги, а не тільки за фактом, що споживач працює. Коли швидкість подій довго перевищує швидкість оброблення, утворюється зростаючий backlog; додавання споживачів допомагає лише якщо є вільні партиції, місце для роботи й немає спільного вузького ресурсу.
Kafka документує режими at-most-once (не більше одного разу) та at-least-once (принаймні один раз). Транзакційний виробник і споживач у режимі read_committed можуть атомарно зв’язати читання з новими записами в Kafka-топіках, але ця гарантія не охоплює довільний зовнішній сервіс (див. 16.13). Для вікон за часом події потрібні також політика пізніх подій і watermark — межа, після якої система вважає дані достатньо повними для попереднього результату. Назви параметрів залежать від рушія та його версії.
Checkpoint — контрольна точка — зберігає позицію читання разом зі станом оброблення, потрібним для продовження після перезапуску. Якщо checkpoint і результат записуються у різні сховища без спільної транзакції, спочатку зафіксований результат може повторитися, а спочатку збережена позиція може пропустити його. Найпростіша безпечна стратегія часто допускає повтор, а запис робить ідемпотентним; інша — погоджує позицію та вихід одним підтриманим транзакційним механізмом. Журнал дає змогу повторно програти діапазон, поки його зберігають. Сам факт використання журналу не робить систему event-sourced: журнал є джерелом істини лише коли продукт свідомо зберігає в ньому всі значущі зміни й може однозначно відтворити стан.
Зворотний тиск (backpressure) виникає, коли джерело подає роботу швидше, ніж споживач може її завершити. Система має обмежувати буфер, уповільнювати чи відхиляти подачу або масштабувати оброблення відповідно до партицій; без такого плану зростатимуть черга й час до результату. Потоку не потрібна кожна задача. Якщо бізнес може дочекатися нічного підсумку і результат можна повторно обчислити з канонічних таблиць, пакетне завдання простіше запускати та відновлювати. Потік вартий складності, коли затримка має значення або інші системи мають отримувати зміни без періодичного повного читання.
Джерела до підглави 16.15: матеріали звірено 23 вересня 2026 року. Apache Kafka 4.1: дизайн топіків, offset і гарантії доставки, протокол Kafka 4.1 пояснює маршрутизацію за ключем та партиціями. Опис потоку бронювань є навчальним; міжпартиційний порядок і зовнішні записи мають окремі обмеження.
Kafka документує режими at-most-once (не більше одного разу) та at-least-once (принаймні один раз), а транзакційний виробник і споживач у режимі читання лише зафіксованих транзакцій (read_committed) можуть атомарно зв’язати читання з новими записами у Kafka-топіках. Це не переносить гарантію на довільний зовнішній сервіс автоматично. Для довгих вікон за часом самої події (event time) система має ще й політику пізніх подій та watermark — межу, до якої вона вважає події досить повними для попереднього результату. Назву поля чи параметра кожного рушія перевіряйте за його версією.
16.16. Захоплення змін і перебудова пошукового індексу
CDC (Change Data Capture — фіксація змін даних) передає зміни канонічного сховища до іншого споживача, не покладаючись на періодичний повний перегляд усіх таблиць. PostgreSQL logical decoding може віддавати зовнішньому читачеві зміни з журналу; логічна реплікація спершу створює початковий знімок, а тоді застосовує наступні зміни. Споживач має зберігати свою позицію так, щоб аварійний перезапуск не пропустив зміни й не спричинив непомітного дублювання. Зміна схеми не передається як рядкова подія автоматично, тому застосунок і цільовий індекс мають окремий план сумісності.
Повний приклад перебудови пошуку. Поточний пошуковий індекс bookings_v1 містить непослідовні документи після зміни правил. Джерелом правди лишаються бронювання у реляційній базі, не пошуковий індекс. Команда створює bookings_v2 із новим відображенням полів і запускає процес, що бере узгоджений знімок та фіксує позицію журналу, на якій цей знімок відповідає стану джерела. Поки сканує рядки, процес зберігає нові події змін, які відбуваються після цієї межі; після завершення початкового завантаження він застосовує їх за порядком версій запису. Повтор події з тією самою версією не створює другий документ і не перезаписує новіший стан.
Перед перемиканням команда звіряє кількість активних бронювань, вибірку документів за ідентифікаторами та кілька пошукових відповідей з канонічними записами. Вона чекає, доки індекс відстає не більше за визначений продуктовою вимогою поріг, перевіряє сигнал помилок і тоді одним атомарним запитом переміщує alias bookings_search з v1 на v2. Запити читання йдуть через alias; споживачі не запам’ятовують назву фізичної версії. Команда зберігає v1 протягом вікна відкату та не видаляє його до перевірки після перемикання. Якщо пошук віддає неправильні результати, alias повертають, виправляють процес і повторюють звірку. Наявність повного індексу без узгодженої позиції змін недостатня: між скануванням і перемиканням могло змінитися бронювання.
Кеш, матеріалізоване подання й пошуковий індекс — різні форми похідних даних; для кожної визначте джерело, допустиму застарілість і відновлення (див. 16.4). Кеш не підтверджує оплату чи право на останнє місце, якщо його свіжість цього не гарантує.
Поточний пошуковий документ можна відновити з повного актуального канонічного запису. Якщо команді потрібна відповідь «що було відомо минулого місяця», а система зберегла тільки теперішній рядок, попередню історичну форму вже не можна вивести з нього. Для такої вимоги треба окремо зберігати версії чи події, а також правила їх строку зберігання. Індекс відновлює потрібне читання лише настільки, наскільки збережене джерело містить необхідні факти.
Джерела до підглави 16.16: матеріали звірено 23 вересня 2026 року. PostgreSQL 18: логічне декодування, логічна реплікація та первинна синхронізація таблиці; OpenSearch: атомарне керування alias. Етапи фонової перебудови й перевірок — навчальна процедура; координування знімка та позиції журналу залежить від CDC-інструмента й джерела.
Кеш також є похідним поданням. Його строк життя, ключі інвалідації, поведінка після недоступності та повна перебудова мають бути видимими. Не використовуйте кеш як остаточний доказ оплати чи права на останнє місце, якщо його допустима застарілість цього не гарантує. Матеріалізоване подання, кеш і пошуковий індекс відрізняються інтерфейсом, але кожен має джерело, затримку, правила оновлення та план відновлення.
16.17. Еволюція схеми і план зміни без зупинки
DDL (Data Definition Language — мова визначення структури даних) змінює таблиці, обмеження чи інші об’єкти бази. Але розгорнутий продукт має не одного читача: старі версії сервісу, фонові задачі, репліки, звіти й інтеграції можуть ще очікувати старі поля. Міграцію плануйте як зміну контракту між одночасно живими версіями, а не як команду ALTER із надією, що всі процеси оновляться разом.
Підхід expand-and-contract (розширити й поступово звузити) проводить сумісну зміну кількома кроками. Спочатку додайте нове поле або нову таблицю так, щоб старий код продовжував працювати. Розгорніть код, який читає обидві форми й записує нову; старий читач ще може існувати. Заповніть історичні рядки порціями, які можна повторити й спостерігати. Перевірте повноту та переведіть читання на нову форму. Лише після зникнення старих читачів припиніть старий запис і видаліть стару структуру. Кожен етап має мати метрику, умову зупинки та безпечний напрям відкату.
Переходьте до нової схеми поетапно:
- Додайте таблиці й сумісний код. До перемикання читачів усі записувачі мають в одній транзакції оновлювати історію та стару проєкцію; інакше старий процес змінить склад без історичного факту.
- Завантажте відновлювані версії з архіву малими ідемпотентними порціями. Пропуски та невідоме походження залишайте видимими.
- Побудуйте тіньову проєкцію, звірте її зі старою таблицею та авторитетним знімком і розгляньте розбіжності перед перемиканням читачів.
- Підтримуйте старе поле протягом вікна відкату. Відкат можливий лише на сумісний записувач, який продовжує атомарно оновлювати історію і проєкцію. Якщо такого немає, зупиніть імпорти, доки сумісний код не буде відновлено й перевірено; не повертайтеся до записувача, який губить історичні факти.
- Приберіть стару структуру після зникнення її читачів, завершення звірки й перевірки відновлення. Якщо попередню історію не вдалося отримати, позначте в продукті й звітах, що повна історія починається лише з дати запуску.
Серіалізація перетворює структурований запис на формат передавання чи зберігання. Для сумісності важливі правила читача: чи приймає він невідомі поля, що означає відсутнє значення та чи не змінився тип поля.
Під час логічної реплікації PostgreSQL визначення схеми не переносяться автоматично; обидві сторони мають узгодити таблиці й додавання стовпців так, щоб потік не зупинився. Так само події інтеграції потребують сумісності старих і нових споживачів. Для кожної зміни визначте, хто ще читає поле, скільки живе старий процес, як відкотити код після заповнення історичних даних, що відбувається зі звітами і як перевірити копію. Міграційний файл без плану сумісності не є повною процедурою.
Вигаданий приклад додавання історії переходів. Початкова схема сайту зберігає лише players.current_team_id, тож відображає теперішній склад, але не пояснює попередні переходи чи час їх набуття чинності. Команда розглядає зміну цієї таблиці на місці та окрему історичну модель. Вона обирає додаткові таблиці: roster_source_revision з унікальним ключем source_system, event_id, revision для доставлених версій; roster_transaction для одного канонічного переходу з внутрішнім transfer_id, player_id, from_team_id, to_team_id, effective_at або effective_date з явною точністю, observed_at та посиланням на прийняту версію; для кожної source_system, event_id зберігається один канонічний transfer_id, а players.current_team_id лишається сумісною проєкцією для старих читачів. Зовнішні й внутрішні ключі мають зовнішні ключі або контрольований реєстр зіставлення. Нові джерельні записи мають обов’язкові ідентифікатор джерела, події, ревізію й observed_at; effective_at заповнюється, коли джерело визначає момент, а дата з її точністю зберігаються окремо, якщо джерело не задає часу. Для старих рядків ці поля можуть бути невідомими: явний стан provenance=legacy_unknown краще за вигадану дату чи source_event_id.
Розгортання йде етапами. Спершу додають таблиці та сумісний код, який ще читає стару проєкцію; усі імпортери мають почати записувати канонічний перехід і старий поточний стан в одній транзакції до перемикання читачів. Інакше старий процес непомітно оновить склад без події в історії. Потім відновлювані версії підтягують з архіву джерела малими ідемпотентними порціями; пропуски та невідоме походження не маскують під точні історичні факти. Команда будує нову проєкцію в тіньовому поколінні, порівнює склад на контрольну дату зі старою таблицею та авторитетним знімком, розглядає кожну розбіжність і лише тоді переводить читання. Старе поле продовжують підтримувати протягом визначеного вікна відкату; прибирають його після зникнення старих читачів, завершення звірки й підтвердження відновлення. Відкат коду має вести на сумісну версію, яка й далі записує канонічну історію та стару проєкцію в одній транзакції; якщо такої версії немає, імпорти лишають призупиненими, доки не відновлено й не перевірено версію, сумісну з подвійним записом. Не можна поновлювати роботу на попередньому записувачі без подвійного запису: він може змінити поточний склад без відповідного історичного факту. Якщо команда не може відновити стару історію, вона може зберегти тільки перевірений поточний стан і почати повну історію з дати запуску — межа повноти має бути видимою в продукті та звітах.
Серіалізація перетворює структурований запис на формат, який можна зберегти чи передати. Наприклад, JSON (JavaScript Object Notation — об’єктна нотація JavaScript) може передати подію бронювання з назвою поля, ідентифікатором і номером версії. Сумісність залежить від правил читача, а не від того, що файл має розширення .json: чи ігнорує він невідомі поля; чи є нове поле необов’язковим; що означає відсутнє значення; чи не змінився тип.
Вигаданий приклад версії контракту події. Пакет нового формату може передавати event_id, revision, player_id, from_team_id, to_team_id та effective_at або effective_date з effective_precision; envelope зберігає source_system і observed_at. Спочатку команда розгортає читачів, які приймають старі події без revision/effective_at і позначають їхнє походження як невідоме, а також нову форму. Вона перевіряє поведінку кожної живої версії читача на обидва формати; невідоме поле дозволено ігнорувати лише якщо це підтверджено контрактом, а не припускається через JSON. Потім виробник додає нові необов’язкові поля для подій v2. Після міграції всіх виробників і перевірки старих черг можна вимагати поля в нових подіях; старі записи не переписують ніби вони від початку мали відомий effective_at. Видалення старих полів або зміна їхніх типів відкладається до зникнення старих споживачів. Backward-сумісність тут означає, що новий читач має визначене трактування старих повідомлень; forward-сумісність — що старий читач працює з новими повідомленнями за перевіреними правилами. Обидві властивості залежать від конкретної схеми, серіалізатора й реалізації читача. Джерела до підглави 16.17: матеріали звірено 23 вересня 2026 року. PostgreSQL 18: команди ALTER TABLE, обмеження логічної реплікації і зміни схеми на підписнику. Протокол Apache Kafka 4.1 стосується клієнт-серверних запитів і відповідей, а не автоматичної сумісності схеми предметних подій. Блокування й тривалість міграції залежать від рушія та його версії.
16.18. Вибір сховища й доступ агента до даних
Починайте вибір зі станів, які мають лишатися правильними, і запитів, які справді потрібні. Порівняйте варіанти за виміряним навантаженням, допустимою затримкою застарілості, роботою з піками, обсягом історії, відновленням, правами, спостережуваністю, вартістю та досвідом команди. Керована послуга може зменшити частину щоденної роботи, але не знімає відповідальності за доступ, резервні копії, конфігурацію, витрати та рішення, які провайдер не може ухвалити за власника продукту.
Межа сервісу не прибирає залежності даних. Якщо бронювання й повідомлення належать різним службам, між ними лишаються мережева затримка, повтори та питання про власника канонічного стану. Розподіл відповідальності впливає на те, де зберігаються дані й як узгоджуються зміни; цю архітектурну тему докладно розглядає книга Software Architecture: The Hard Parts.
Завершений приклад запиту агента. Оператор питає: «Скільки бронювань було минулого тижня?» Агент викликає контрольований інструмент звіту з датами й часовою зоною, а той застосовує право оператора, читає лише потрібні поля й повертає число, область звіту та час актуальності. Відповідь «37, дані оновлено о 09:00» вказує джерело й межу свіжості; модель не вигадує точності, якої не повернув інструмент. Для запиту «підтверди останнє місце» агент не формує довільний запис у таблицю: він викликає предметну операцію, яка перевіряє місткість і версію в транзакції. Операція повертає «підтверджено», «місце зайняте» або невизначений результат із ключем повтору. Після тайм-ауту агент не стверджує, що дія не відбулася, а перевіряє стан за цим ключем або просить оператора розв’язати невизначеність.
Дайте агенту вузький доступ до потрібних полів через рольове подання або параметризований запит із межами за рядками, часом і розміром відповіді. Перевірка власника має діяти в інструменті чи сховищі, а не лише в тексті інструкції. Зміни виконуйте через предметну операцію з перевіркою версії або ключем повтору. Журналюйте назву інструмента, ідентифікатор запиту, користувача, версію та результат без зайвих приватних даних. Модель не підтверджує виконання дії — перевіряйте стан, повернений операцією.
Завершений приклад вибору для служби бронювання. Команда має канонічні клієнтів, слоти й бронювання, щоденний звіт та пошук за датою і клієнтом. Вона перевіряє інваріант останнього місця й починає з однієї реляційної бази, де бронювання захищене обмеженням і транзакцією. Звіт спершу читає ті самі таблиці; лише після вимірювань, що підтверджують заваду операційному запису, команда додає матеріалізований підсумок із позначкою актуальності. Пошуковий індекс лишається похідним і перебудовується з канонічних записів. Команда обирає керовану базу, якщо її ресурсу й договору достатньо для вимог доступності, а окремий власний черговий не потрібен; перед вибором вона перевіряє відновлення, затримку репліки та доступи. Шардінг, консенсусну службу чи потоковий рушій не додають заради гіпотетичного майбутнього навантаження. До рішення повертаються після виміряного вузького місця, нової вимоги до відновлення або зміни доменного інваріанта.
Межа сервісу не прибирає залежності даних. Якщо підтвердження бронювання й повідомлення клієнтові належать різним службам, між ними з’являються мережевий виклик, повтори, затримка та питання про власника канонічного стану. Розподіл відповідальності впливає на те, де зберігаються дані й як узгоджуються зміни; це пов’язано з темою архітектурних компромісів у Software Architecture: The Hard Parts (сторінка книги).
Застосунок із моделлю штучного інтелекту (англ. Artificial Intelligence, AI) додає ще один рівень: система може пояснити запит або запропонувати дію, але повноваження визначає інструмент, сервер і база. Підказка в тексті не має надавати доступ до чужого клієнта чи розширювати право запису. Звичайний обліковий запис агента не повинен отримувати ширші права, ніж потрібні його конкретному завданню.
Обмежте читання рольовими поданнями та параметризованими запитами; застосовуйте межі за рядками, полями, часом і розміром відповіді. Перевірка власника має діяти в інструменті чи сховищі, а не лише в тексті інструкції. Зміни проходять через предметну операцію з доменною перевіркою, версією або ключем повтору; значущу зовнішню дію можна винести на окреме погодження. Журналюйте назву інструмента, ідентифікатор запиту, користувача, прочитану версію й результат без зайвих приватних значень. За потреби перевіряйте поведінку на контрольних сценаріях.
Джерела до підглави 16.18: матеріали звірено 23 вересня 2026 року. Документація OpenAI API, Agents, описує багатоетапну роботу з інструментами; Anthropic: Building Effective AI Agents розглядає перевірку агентних процесів. Ці матеріали не визначають поведінку бази даних чи зовнішнього сервісу.
Підсумок
Починайте із записаних інваріантів, реальних запитів і меж відновлення. У межах одного сховища обмеження, атомарні транзакції та конкурентний контроль захищають спільні записи; для реплік, черг, індексів і зовнішніх сервісів окремо визначайте затримку, повтор, порядок та відновлення. Похідні представлення мають назване канонічне джерело й перевірюваний спосіб перебудови; історію зберігають тоді, коли її вимагає продукт. Оберіть найпростішу архітектуру, яка виконує вимоги вимірюваннями й визначеними гарантіями, а складнішу вводьте через конкретну причину, власника, моніторинг і план відкату.